 東京科学大学 研究
既知の抗体データベースに頼らず、AIで免疫応答を追跡
抗体言語モデルと時系列BCRレパトア解析を統合した「LM-QASAS」を開発
【注目の成果:共同研究・産学連携のためのチェックポイント】
 | 新興感染症や抗体情報の乏しい抗原に対するワクチン評価をはじめ、自己免疫疾患やがん免疫など、幅広い液性免疫応答のモニタリングへの応用が期待 |
【産学連携対象 全学共通分野 Discovery Saga】
【Sagaキーワード】
高次元データ/情報量/フレームワーク/機械学習/言語モデル/自然言語/自然言語処理/情報学/深層学習/人工知能(AI)/言語処理/局所密度/相補性/埋め込み/クローン/定量評価/マイクロ/モニタリング/性決定/アミノ酸配列/抗原受容体/SARS-CoV-2/液性免疫/がん免疫/幹細胞移植/血清/次世代シークエンサー/mRNA/細胞移植/造血幹細胞/B細胞/アミノ酸/アルブミン/インフルエンザ/幹細胞/環状ペプチド/血液/抗原/自己免疫/自己免疫疾患/受容体/免疫応答/ウイルス/ワクチン/感染症/抗体/新型コロナウイルス感染症/造血/造血幹細胞移植/標準化
2026年9月9日 公開
ポイント
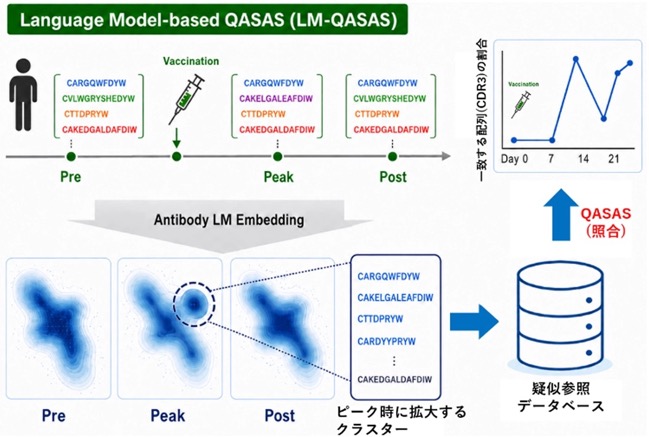
従来のQASASは既知の抗体配列データベースを参照するため、十分な抗体情報がない新興感染症や未知抗原への適用に制約がありました。解析法「LM-QASAS」は、IgG BCRのCDR-H3配列を抗体言語モデルAbLang2で480次元の数値表現に変換し、接種前からピークにかけて局所密度が上昇し、その後低下する配列集団を抗原応答性BCR候補として抽出します。
SARS-CoV-2関連の10名を対象とした検証では、LM-QASASは既知のSARS-CoV-2抗体に類似した配列を効率よく抽出したほか、残りの9名のデータから構築した疑似参照データベースを用いて、外部データベースなしに免疫応答の推移を追跡できることを示しました。
本研究により、多様性が極めて高い抗体配列(CDR3領域)においても"深層学習(言語モデル)による生物学的な意味理解が可能であること"をワクチン接種症例を用いて示すことができました。
今後、対象となる抗原や症例数を拡大し解析精度を高めることで、新興感染症や抗体情報の乏しい抗原に対するワクチン評価をはじめ、自己免疫疾患やがん免疫など、幅広い液性免疫応答のモニタリングへの応用が期待されます。
概要
東京科学大学(Science Tokyo)情報理工学院情報工学系 大上雅史准教授、増田元希大学院生、飯棲俊介大学院生(当時)ならびに神戸大学医学部附属病院 腫瘍・血液内科の船越洋平講師、薬師神公和准教授、南博信教授、感染症内科の大路剛准教授らは、抗体言語モデルとワクチン接種前後のB細胞受容体(BCR)レパトア[用語1]を組み合わせ、既知の抗原特異的抗体データベースを使わずに、免疫刺激に反応した可能性の高いBCR配列候補を抽出・追跡する解析法「LM-QASAS」を開発しました(QASAS[用語2], Quantification of Antigen-specific Antibody Sequence:特定の抗原に対する免疫反応を抗原受容体レパトア解析を用いて定量評価する方法)。SARS-CoV-2に関連する10名のデータを解析したところ、抗体言語モデル[用語3]により抽出された上位候補には、既知抗体に似た配列が、ランダム抽出より多く含まれました。また、10名のうち1名を除き、残り9名のデータから作った「疑似参照データベース[用語4]」を用いた結果、除外した1名の免疫応答の上昇、ピーク、低下までを再現できました。
LM-QASASは、既知の抗体情報が十分に蓄積していない新興感染症などにおいても、複数人のBCRレパトアから作成した疑似参照データベースを用いて、新たな個人の免疫応答を追跡できる可能性を示しました。これらの結果は、多様性が極めて高い抗体配列においても"深層学習(言語モデル)による生物学的な意味理解が可能であること"を示したものと考えています。今後、対象となる抗原や症例数を拡大し解析精度を高めることで、ワクチン評価をはじめ、感染症、自己免疫疾患、がん免疫など、さまざまな液性免疫応答を捉える解析基盤への発展が期待されます。
本研究成果は、2026年7月30日に国際学術誌『Frontiers in Immunology 』にオンライン掲載されました。
背景
B細胞は、抗体として働くB細胞受容体(BCR)を細胞表面に持っています。体内には理論上10の14乗にも及ぶ多様なBCRが存在し、その集合である「BCRレパトア」には、感染やワクチン接種、自己免疫反応など、一人ひとりの免疫の履歴が刻まれています。次世代シークエンサーにより多数のBCR配列を一度に読めるようになりましたが、膨大な配列の中から、ある抗原に実際に反応した配列だけを見つけることは依然として難しい課題です。研究グループがこれまで開発してきたQASASは、ワクチン接種などの前後で得たBCRレパトアを、既知の抗原特異的抗体データベースと照合することで、特定抗原への免疫応答を時系列で可視化します。COVID-19のように多くの抗体配列が蓄積した領域では有用ですが、新興感染症や抗体情報が乏しい疾患では、参照できるデータベース自体がありません。そこで本研究では、外部の正解データに依存せず、レパトア内部の構造と時間変化から応答配列候補を自律的に見いだす方法を目指しました。
研究成果
1.抗体の「言語空間」で、一過性に密集する配列を探す
LM-QASASでは、抗体重鎖の抗原認識に重要なCDR-H3[用語5]アミノ酸配列を、抗体言語モデルAbLang2に入力し、各配列を480次元の埋め込み表現[用語6]へ変換します。意味や機能が近いとモデルが判断した配列は、この高次元の「意味空間[用語6]」で近くに配置されます。研究グループは、刺激前(Pre)、応答ピーク(Peak)、ピーク後の収束期(Post)の各レパトアを空間上の分布として扱い、Preでは疎だったがPeakで局所密度が上がり、Postで再び低下する領域を探索しました。候補抽出にはK-means法(K=500)とk近傍法(k=200)の2方式を用いました。図1は、健康なmRNAワクチン接種者1名の代表例です。中央のピーク時に新たな高密度領域が現れています。そして、その領域に、既知のSARS-CoV-2抗体配列(公共データベース:CoV-AbDab[用語7]を使用)(赤点)が集積しました。ピーク後には密度と赤点が減少しましたが、一部は残存しました。図では理解しやすいようUMAP[用語8]で2次元化していますが、実際の密度推定と候補抽出は情報量を保った480次元空間で行いました。
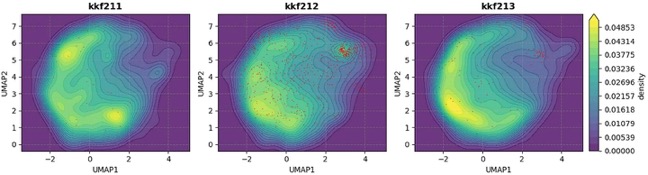
代表的な健康mRNAワクチン接種者の接種前、応答ピーク、ピーク後(左から)を示します。背景色は配列の局所密度、赤点はCoV-AbDabの既知SARS-CoV-2抗体と85%以上類似する配列です。ピーク時に新たな高密度領域へ赤点が集積し、その後減少しました。赤点は抽出後の検証にのみ用い、候補抽出はUMAP表示ではなく480次元の埋め込み空間で行いました。出典:Masuda et al., Frontiers in Immunology (2026), Figure 1Cを抜粋。
これにより、自然言語処理と同様に、抗体言語モデルが多様性の高いCDR-H3配列から、単純な配列一致を超えた生物学的特徴を捉えられる可能性が示されました。
2. SARS-CoV-2関連の10名で、抽出候補を外部データベースにより事後検証
検証には、健康なSARS-CoV-2 mRNAワクチン接種者4名、COVID-19罹患者3名、造血幹細胞移植後のmRNAワクチン接種者3名、計10名の時系列IgG BCRレパトアを用いました。LM-QASASで候補を抽出した後、既知のSARS-CoV-2抗体データベースCoV-AbDabと85%以上の配列同一性を示す候補の割合を調べました。K-means版LM-QASASでは、上位50候補の一致率が26.4%で、ランダム抽出の1.4%を大きく上回りました。上位100候補では24.8%対1.1%、上位300候補では15.6%対1.47%でした。また健康mRNAワクチン接種者に限ると、上位300候補の平均一致率は30.75%(ランダム2.33%)でした。これは、外部データベースを使わずに抽出した候補の中へ抗原関連配列が濃縮されていることを支持します。
| 抽出条件 | LM-QASAS(K-means) | ランダム抽出 |
|---|---|---|
| 上位50候補(全10名) | 26.4% | 1.4% |
| 上位100候補(全10名) | 24.8% | 1.1% |
| 上位300候補(全10名) | 15.6% | 1.47% |
| 上位300候補(健康mRNAワクチン接種者4名) | 30.75% | 2.33% |
(論文Table1の一部)数値は、各手法で抽出した候補配列のうち、CoV-AbDabに登録された既知SARS-CoV-2抗体のCDR-H3配列と85%以上類似した配列の割合を示します。CoV-AbDabは候補抽出には使わず、抽出後の事後検証にのみ用いました。
3. 他者から作った疑似参照データベースで、免疫応答の時間変化を再現
次に、10名のうち1名を解析から除外し、残り9名のピーク時レパトアから各手法の上位300配列を抽出して疑似参照データベースを作成しました。その疑似データベースを用いて除外した1名を解析する操作を10名分繰り返す、leave-one-out交差検証を行いました。LM-QASAS由来の疑似データベースは、外部の既知抗体データベースを用いなくても、各個人の免疫応答の上昇、ピーク、低下を再構成しました。健康mRNAワクチン接種者では、概ね接種後7日前後にピークがみられました。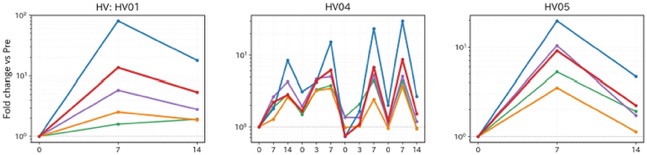
健康mRNAワクチン接種者3名(HV01、HV04、HV05)について、接種前を1とした配列オーバーラップ率の変化を対数目盛で示します。赤:LM-QASAS(K-means)、青:LM-QASAS(k-NN)、橙:埋め込み表現を用いない比較対象であるSeq-QASAS(k-NN)、緑:Random、紫:既知SARS-CoV-2抗体データベースCoV-AbDab。HV04では複数回の追加接種に伴う反応も追跡されました。出典:Masuda et al., Frontiers in Immunology (2026), Figure 2をもとに作成。
今後の展開
LM-QASASは、既知抗体の配列データの蓄積を待たずに、時系列BCRレパトア自体から抗原応答性候補を抽出し、それを疑似参照データベースとして次の個人の免疫応答追跡に利用する道を示しました。新興感染症の発生直後や、抗体データが乏しい抗原に対するワクチン評価など、迅速な液性免疫モニタリングへの応用が期待されます。本研究の限界として、既知抗体との一致率はランダム抽出を上回った一方、時系列追跡ではランダム抽出でも一部にピーク様変化がみられ、他の参照配列非依存法との差も統計学的に有意ではありませんでした。さらに、インフルエンザでは明瞭な動態を捉えられず、今後、モデルの更なる高精度化が必要だと考えています。現在、刺激前、応答ピーク、収束期を捉える採血設計を標準化し、再現性のある評価基盤を構築するため、水痘・帯状疱疹ウイルス、RSウイルスワクチン接種検体によるLM-QASAS解析に取り組んでいます。本研究を進めることで、感染症にとどまらず、ワクチン開発、自己免疫疾患、がん免疫などで生じる液性免疫応答を、抗原特異的データベースの有無に左右されず評価する基盤へ発展させることを目指します。
付記
本研究は、日本学術振興会 科学研究費助成事業(JP25K08401、JP26H02544)、科学技術振興機構(JST)創発的研究支援事業(JPMJFR216J)、日本医療研究開発機構(AMED、JP25ym0126805)、上原記念生命科学財団の支援を受けて実施されました。用語説明
- [用語1]
- B細胞受容体(BCR)レパトア:一人の体内に存在する多様なBCR配列の集合です。感染やワクチン接種などに応じて特定のB細胞クローンが増減するため、免疫応答の履歴を反映します。
- [用語2]
- QASAS(Quantification of Antigen-specific Antibody Sequence):「検査対象者のBCRレパトアデータ」と、「特定の抗原に結合するBCR/抗体配列を集めたデータベース」を情報科学的に照合することで、特定の抗原に対する免疫反応を抗原受容体レパトア解析を用いて定量評価する独自技術です。各検体のBCRレパトアデータの中に、データベース内の配列と一致するものが、どの程度存在するか、一致配列のクローン数と割合の推移をグラフにします。
- [用語3]
- 抗体言語モデル(Antibody Language Model):大量の抗体アミノ酸配列から配列の規則性を学習した機械学習モデルです。本研究ではAbLang2を用い、各CDR-H3配列を480次元の数値表現へ変換しました。
- [用語4]
- 疑似参照データベース:LM-QASASなどが時系列レパトアから抽出した候補配列を集めたデータベースです。既知抗体データベースの代わりに、別の個人の免疫応答を追跡するために用います。
- [用語5]
- CDR-H3(complementarity-determining region H3):抗体重鎖にある相補性決定領域3で、抗原認識に特に重要な配列領域です。多様性が極めて高く、BCRクローンを特徴づける主要な手掛かりになります。
- [用語6]
- 埋め込み表現・意味空間:配列の特徴を多数の数値へ変換したものが埋め込み表現です。似た性質を持つとモデルが判断した配列が近くなる空間を、本稿では意味空間と呼びます。
- [用語7]
- CoV-AbDab:SARS-CoV-2などのコロナウイルスに結合することが報告された抗体配列の公開データベースです。本研究ではLM-QASASの候補抽出には使わず、抽出候補を事後評価する外部基準として用いました。
- [用語8]
- UMAP・KDE:UMAPは高次元データを2次元などに圧縮して可視化する方法、KDEは点の密度を滑らかに表示する方法です。図1の表示に使用しましたが、LM-QASASの候補抽出そのものは480次元空間で行いました。
論文情報
- 掲載誌:
- Frontiers in Immunology, Volume 17, Article 1844788(Original Research)
- タイトル:
- LM-QASAS: reference-free identification of antigen-specific sequences from the BCR repertoire using antibody language models
- 著者:
- Genki Masuda, Yohei Funakoshi*, Shunsuke Iizumi, Kimikazu Yakushijin, Goh Ohji, Hironobu Minami, Masahito Ohue*
*責任著者 - DOI:
- 10.3389/fimmu.2026.1844788
関連リンク
プレスリリース 既知の抗体データベースに頼らず、AIで免疫応答を追跡—抗体言語モデルと時系列BCRレパトア解析を統合した「LM-QASAS」を開発—(PDF)未知の触媒をつくりだせ:新たなAI「CatDRX」を開発 | Science Tokyoニュース
幅広い化学反応に対応するAIフレームワーク「CatDRX」 | Science Tokyoニュース
構造が大きく異なる化合物ペアにFEP計算を適用する新規手法を開発 | Science Tokyoニュース
大上准教授、片瀬准教授が2024年度「Science Tokyoの星」特別賞【STAR】に決定 | Science Tokyoニュース
2024年ノーベル化学賞を読み解く:計算でタンパク質の構造を予測し、新しいタンパク質を作る | Science Tokyoニュース
薬剤設計を支援する解釈性の高いAI予測手法を開発 | 旧・東京工業大学
環状ペプチドのヒト血清アルブミンに対する結合様式を解明 | 旧・東京工業大学
大上雅史准教授が2023年度マイクロソフト情報学研究賞を受賞 | 旧・東京工業大学
大上雅史助教が第35回安藤博記念学術奨励賞を受賞 | 旧・東京工業大学
東工大関係者6名が平成31年度科学技術分野の文部科学大臣表彰を受賞 | 旧・東京工業大学
大上 雅史 Masahito Ohue | Science Tokyo研究情報データベース(理工学系)
大上研究室
情報理工学院 情報工学系
情報理工学院
神戸大学
問い合わせ先
東京科学大学 情報理工学院 情報工学系准教授 大上 雅史
- ohue@comp.isct.ac.jp
神戸大学医学部附属病院 腫瘍・血液内科
講師 船越 洋平
- yohei@med.kobe-u.ac.jp
取材申し込み
東京科学大学 総務企画部 広報課- media@adm.isct.ac.jp
- Tel
- 03-5734-2975
- FAX
- 03-5734-3661
神戸大学企画部広報課